Showing posts with label news. Show all posts

Friday, 13 February 2015

Để trở thành Hacker: Script Kiddy Level - HVA Online

Nguồn: HVA Online

Bài viết này sẽ tách ra làm 4: Script Kiddy Level, Advanced Attacker Level, Developer Level, Researcher Level

Nội dung bài viết phản ánh quan điểm của tác giả, và hoàn toàn rộng mở cho mọi người comment góp ý chỉnh sửa, comment góp ý nào được nhiều người Like nhất sẽ được cân nhắc bổ sung, thay thế vào bài viết ( kèm credits ). Bài viết cũng cố gắng sử dụng các ngôn từ mà các bạn trẻ hay dùng trong giới Hắc-cờ VN nên có thể các từ này không chính xác về mặt kỹ thuật, vui lòng không bắt bẻ :v

Về bài viết này:

Mức độ: cực kỳ căn bản
Đối tượng: biết xài máy tính thông thạo
Yêu cầu cần có sẵn:

  • Biết bật máy tính
  • Biết lướt web
  • Biết search bằng Google
  • Biết cài & gỡ chương trình. Hay tóm gọn lại là biết cài Win =))
  • Biết tiếng Anh mức độ Đọc rất tốt, viết người ta hiểu được, nghe nói thì tạm tạm nếu có thêm chân tay chỉ trỏ ( ếu biết đi chỗ khác chơi )
Yêu cầu về tố chất:
  • Đang có hy vọng trở thành hacker
  • Chịu khó nghịch
  • Chịu khó tìm hiểu
  • Không lười
  • Không hy vọng một đêm thành hacker :v ( các cháu hy vọng điều này thì các cháu đi coi phim đi cho thoả mãn )
—————————————————

Script Kiddy là gì ?

Là mức độ căn bản nhất của một người đang có hy vọng thành hacker. Những người này thường sử dụng máy tính ở mức thông thạo, tức là khá hơn người dùng bình thường ( đến dùng còn ếu thạo thì đừng mong hắc hiếc gì ), thường hay đi hỗ trợ các chị em sửa máy khi được nhờ giúp giải quyết một cái máy có vấn đề.
Ngoài các lúc đi hỗ trợ gái ( hoặc trai :v ) sửa máy thì thời gian còn lại là lên mạng đọc Tut, và làm theo với hy vọng sớm thành hacker, làm theo các tut trong tình trạng là ếu hiểu mền đang làm gì và lý do tại sao phải làm bước A B C, và đa phần là cũng ếu tự thắc mắc luôn, các em mà không biết tự thắc mắc kiểu "tại sao phải làm bước A B C mà không phải làm các bước X Y Z” thì coi như không có tố chất lên các level tiếp theo, mãi mãi chỉ có đi sửa máy cho gái ( hoặc trai :v ) và làm theo Tut để loè gái. Còn các em tự biết hỏi “tại sao…” , “tại sao …” và biết lên mạng search và tìm hiểu thì có cơ hội lên các level tiếp theo mà gần nhất là Attacker :)

Script Kiddy cần có kiến thức gì?

Dưới đây là một danh sách các kiến thức mà Script Kiddy cần có để được coi là đạt mức độ này và có tiềm năng lên các level cao hơn

Script Kiddy Level Basic:
- Biết xài Windows
- Biết cài/gỡ chương trình trên Windows
- Biết dùng các công cụ quản lý HDH Windows
- Biết cài HDH Windows
- Biết xử lý các sự cố trong quá trình sử dụng HDH Windows
- Biết xài bộ Office ở mức độ thông thạo, tức là làm được cái văn bản đẹp, slide powerpoint ngon, thuộc làu và dùng tốt hầu hết các công thức Excel. Bèo bèo thì cũng phải có được cái bằng A & B Tin học của VN cấp :v ( ý là kiến thức phải đạt cỡ đó )
- Biết hầu hết các trò chỉnh sửa, tối ưu windows như chỉnh msconfig, chỉnh registry, chỉnh startup, chỉnh boot option…
- Biết xài Windows Command Line ( cmd.exe )
- Biết xài file Batch ( .Bat )
- Biết máy hư phần cứng thì phải thay cái gì. Nói chung máy hư thì ít khi phải mang ra tiệm nhờ sửa máy :v
- Biết mấy trò nghịch phá trên máy Windows như lock registry, lock task manager, lock desktop wallpaper

Script Kiddy Level Medium:
- Biết cấu hình modem ADSL để vô mạng
- Biết setup cho một máy đơn có thể vô mạng internet
- Biết lập mạng Lan, mạng Wifi
- Biết lắp ráp nguyên một cái máy tính để bàn từ các thành phần rời ( hề hề vụ này giờ chắc ít người biết :v ). Hoặc là biết cách tháo cái Laptop ra và gắn lại mà vẫn chạy ngon :v
- Biết quản lý share windows share file
- Biết quản trị mạng căn bản & nâng cao ( đi học mấy khoá Quản trị mạng của mấy trung tâm tin học cũng được )

Script Kiddy Level Advanced:
- Biết lập trình căn bản bằng một ( hoặc nhiều ) ngôn ngữ trong nhóm sau: Java, C/C++, Visual Basic, C#. Căn bản tức là viết được một chương trình cho Desktop PC làm công việc như là quản lý một kho sách, quản lý một quán cafe. Cao hơn làm một chương trình Chat giữa 2 máy tính thông qua mạng LAN. Kiểu kiểu như vậy. Thường Script Kiddy nào lập trình được mấy món kể trên thì bắt đầu thấy sáng mắt ra và tự nhìn thấy tương lai rõ ràng hơn :)

- Biết lập trình Web căn bản bằng các ngôn ngữ sau: PHP, Javascript, HTML, CSS, SQL. Căn bản là tự lập trình được một trang web bán hàng đơn giản ( tự lập trình chớ không phải là tải mấy cái source có sẵn rồi về cài lên, việc cài thì đám Script Kiddy Level Medium dư sức làm ). Nâng cao thì có thể biết thêm các thứ như Bootstrap, HTML5, jQuery, biết một Web Framework như Zend, Symphony… . Cao hơn nữa thì biết chỉnh sửa các web mã nguồn mở như Joomla, Wordpress

- Biết xài một số ngôn ngữ lập trình tiện ích như: Autoit, Python, Perl, Unix Bash Shell

- Biết xài Linux. Biết xài ở đây nghĩa là “xài linux dễ dàng và tự nhiên như xài windows”, có thể coi lại phần Script Kiddy Level Basic chỗ nói về Windows

- Biết đọc & hiểu các Tut hướng dẫn Hack bằng tiếng Việt lẫn tiếng Anh, và hầu hết là làm theo thành công ( đôi lúc không thành công thì cũng không sao :v ). Còn nếu hầu hết mà làm theo không thành công, thì rất tiếc, tới level này mà làm theo Tut có sẵn mà đa phần không thành công thì chứng tỏ không có tố chất để thành Hắc-cờ, một số điều cần phải có tố chất bẩm sinh, nên đừng buồn, tới level này thì cũng có thể thấy tương tai kiếm ăn với ngành CNTT được rồi :)

- Hiểu các Tut nói gì, khi làm theo mà gặp khó khăn, biết phải search cái gì để giải quyết khó khăn đó, và làm theo Tut thành công

- Tự mày mò thử nghiệm hack cái gì đó thành công, và tự viết Tut hướng dẫn lại cho người khác cách hack

- Có một lượng fan nho nhỏ :v và giúp định hướng được cho một số người đạt được các thành công nho nhỏ như mình và đạt được Script Kiddy Level Advanced như mình.


Những nguời tới được mức này thì coi như đã đủ tố chất và tiềm năng để lên Advanced Attacker Level. Những người này cũng thường nhìn thấy được con đường có thể kiếm ăn bằng nghề làm việc với công nghệ ( đa phần là cũng kiếm ăn được chút chút rồi ).


Sách nên đọc: ...
Nơi nên theo học: …

Hai phần Sách nên đọc & Nơi nên theo học, tôi cần sự góp ý và đóng góp từ mọi người, do các sách tôi đã đọc đa phần giờ khó tìm theo tựa và tôi cũng không theo học nơi nào cả, dù đến giờ tôi nhận ra là việc “không theo học nơi nào cả” là một lựa chọn “mất sức” không đáng có.

xnohat - HVA ( 2014 )

Thursday, 18 April 2013

Dân IT nên viết CV như thế nào?

Dân IT nên viết CV như thế nào?


"Theo chia sẻ của anh Đại Trần, VP of Delivery - KMS Technology"

Một CV rõ ràng, khúc chiết, chuyên nghiệp nhưng thể hiện được cá tính, nêu bật được những thế mạnh của bạn trong lúc vẫn cung cấp đầy đủ thông tin về những kinh nghiệm trong quá khứ sẽ khiến bạn nổi bật trong số những ứng viên và giúp nhà tuyển dụng hiểu rõ về bạn để có thể quyết định nên hay không nên sắp xếp phỏng vấn. Nếu bạn không thể viết một cái CV ra hồn để mô tả bản thân, thì rõ ràng bạn có một khiếm khuyết rất lớn, có thể đó là khả năng diễn đạt, hay hiểu biết về chính mình và ngành mình đang làm việc, hoặc không nghiêm túc trong việc xin việc hoặc đơn giản là bạn không thể làm gì ra hồn cả. Dù khiếm khuyết của bạn là gì, nhà tuyển dụng có thể sẽ gạt bạn ra một bên, hoặc may mắn lắm là họ sẽ hướng dẫn bạn làm lại CV, và lần này sẽ là cơ hội cuối cùng cho bạn.

Theo kinh nghiệm của tôi, một CV cho ngành IT nên có 6 mục sau:
1. Thông tin cá nhân:
Chỉ cần liệt kê đơn giản Tên, Năm sinh, Địa chỉ nơi ở, số điện thoại, email, có thể thêm hình thẻ. Các thông tin về giới tính, tình trạng hôn nhân, quê quán ... thực sự không cần thiết và mang tính phân biệt nên không nên đưa vào.
2. Mục tiêu nghề nghiệp (Objectives):
Nêu rõ định hướng của bạn trong con đường nghề nghiệp của mình. Định hướng này có thể được thay đổi theo thời gian, nhưng là định hướng duy nhất khi bạn tìm việc trong giai đoạn hiện tại mà không phụ thuộc vào bạn đang nộp đơn vào công ty nào. Một ví dụ cho Objectives: "Tìm được một công việc trong môi trường chuyên nghiệp, tôn trọng lẫn nhau và tận dụng được kinh nghiệm lập trình J2EE tôi đã tích lũy được trong 5 năm qua. Cơ hội làm việc trực tiếp với khách hàng bằng tiếng Anh. Ưu tiên cho những công việc có tính chất quản lý, tuy nhiên vẫn chấp nhận những công việc làm việc độc lập với tính chuyên môn kỹ thuật cao"
Chỉ nên liệt kê những mục tiêu thực sự quan trọng với bạn (ví dụ một thứ mà bạn không thể có và phải nghỉ việc hiện tại để tìm việc khác). Không nên dùng mục này để đánh bóng cá nhân, để chứng tỏ bạn có hoài bão, vì nó có thể khiến bạn bị loại nếu vị trí nhà tuyển dụng đang tìm không thể giúp bạn đạt được những mục tiêu của mình. Ví dụ một sinh viên mới ra trường, không có gì đặc biệt mà có Objective trở thành nhà quản lý dự án sau 2 năm làm việc sẽ có khả năng bị loại nhanh chóng trong giai đoạn lọc CV, vì xác suất bạn không đạt được objective này là rất cao và bạn sẽ không hài lòng với công việc.
3. Kỹ năng (Skilll sets):
Chỉ nên liệt kê những gì bạn biết và/hoặc có kinh nghiệm và nêu chính xác mức độ hiểu biết của bạn trong từng mục. Một sinh viên mới ra trường có kỹ năng C++ cấp Expert (4/5) sẽ gây sự chú ý tới nhà tuyển dụng, nhưng nếu tất cả những mục khác đều 2, 3, 4 (ví dụ Java cấp 3/5, Oracle 3/5 ...) thì nhà tuyển dụng sẽ gạt qua nguyên mục này, bởi lẽ đơn giản là mất ít nhất 5 năm kinh nghiệm làm việc trên 1 kỹ thuật nào đó để có thể đạt cấp 4/5, nên việc bạn có nhiều kỹ năng đạt cấp 3 hoặc 4 chỉ có nghĩa là bạn có hiểu biết rất hẹp về những kỹ năng này và không thể tự đánh giá. Nếu bạn chưa có nhiều kinh nghiệm, chỉ nên phân loại theo thời gian làm việc với từng kỹ năng, ví dụ:
  • Level 1: Biết qua (học hoặc tự nghiên cứu)
  • Level 2: Có kinh nghiệm sử dụng thực tế dưới 6 tháng.
  • Level 3: Có kinh nghiệm sử dụng thực tế dưới 2 năm.
  • Level 4: Có kinh nghiệm sử dụng thực tế dưới 5 năm.
  • Level 5: Có kinh nghiệm sử dụng thực tế trên 5 năm.
Nên giải thích chi tiết cách phân level của bạn để nhà tuyển dụng hiểu cách bạn đánh giá và hãy trung thực với đánh giá của mình. Nếu bạn viết 1 ứng dụng Struts web application trong 1 năm, hãy liệt kê 1 năm cho JSP/Servlet/Java, 2 tháng cho Struts và 1 tháng cho MSSQL, đơn giản là vì bạn chỉ thực sự dính dáng tới Struts framework và database rất ít trong quá trình làm việc, trong khi phần lớn thời gian dành cho lập trình các trang web JSP và servlet.
Không nên liệt kê những kỹ năng không quan trọng (ví dụ MSWord, Excel đối với lập trình viên), trừ khi bạn thực sự là chuyên gia trong những kỹ năng này.
Theo kinh nghiệm của tôi, tôi đã bỏ qua không đọc tiếp phần skillsets của hơn 90% CV tôi từng đọc qua. Con số này phản ánh tình trạng chung là các ứng viên không tự đánh giá hoặc không diễn đạt được khả năng của mình.
4. Kinh nghiệm làm việc:
Nếu bạn làm việc qua nhiều công ty, nên có phần tóm tắt: liệt kê giai đoạn nào làm việc trong công ty nào, chức vụ.
Sau đó liệt kê danh sách các dự án hoặc nhóm dự án có liên quan tới nhau, theo thứ tự từ mới nhất (hiện nay) đến cũ nhất. Mỗi dự án nên có các thông tin sau:
- Mô tả dự án: Ngoài thông tin về sản phẩm phần mềm, hãy nói rõ công việc của dự án. Ví dụ: Ứng dụng quản lý bệnh viện XYZ cung cấp đầy đủ các nghiệp vụ cần thiết trong một phòng khám tư nhân ở Việt Nam. Dự án X kéo dài 5 tháng nâng cấp ứng dụng XYZ để hỗ trợ mô hình chuỗi phòng khám và chuyển từ hosting nội bộ lên Amazon EC2.
- Quy mô dự án: Để nhà tuyển dụng có thể hình dung dự án này lớn hay nhỏ, nên có thông tin này. Có thể dùng man-month hay số người+thời gian.
- Số người làm việc trên dự án.
- Nhiệm vụ cụ thể của bạn trên dự án này. Điều này rất quan trọng, vì có thể dự án rất hoành tráng nhưng công việc của bạn chỉ làm việc trên một phần nhỏ thì cũng nên nói rõ từ đầu.
- Kỹ năng bạn học được trong dự án này. Chỉ liệt kê những kỹ năng bạn thực sự sử dụng và thời gian bạn sử dụng chúng. Tránh liệt kê tất cả những kỹ thuật dụng trong sản phẩm, mặc dù bạn không hề làm việc với những phần đó (hoặc rất ít).
5. Thành tựu:
Liệt kê thành tựu cá nhân của bạn trong dự án này, ví dụ khi tham gia bạn chỉ mất 15 ngày là có thể làm việc hiệu quả trong khi thời gian trung bình cho người mới là 1 tháng, bạn đã tìm ra giải pháp tăng hiệu suất lên gấp đôi ... nói chung là những gì bạn tự hào mình đã làm được cho dự án này.
- Số người bạn quản lý khi làm việc trong dự án này.
Việc mô tả đầy đủ thông tin về dự án rất quan trọng vì nó giúp cho nhà tuyển dụng có thể hình dung ra được những gì bạn đã làm trong quá khứ, từ đó hình dung ra bạn sẽ có thể đóng góp như thế nào khi tham gia công ty của họ.
Nếu bạn làm rất nhiều dự án nhỏ, có thể nhóm lại thành một và liệt kê theo dạng bảng (với mỗi hàng là 1 dự án, mỗi cột là một mục thông tin liệt kê ở trên).
6. Các thông tin khác:
- Bằng cấp, đào tạo.
- Giải thưởng, các dự án riêng.
- Không cần thiết liệt kê các môn thể thao yêu thích hay các hoạt động xã hội bạn tham gia. Cũng như giới tính, tình trạng hôn nhân ..., hãy cho nhà tuyển dụng biết là bạn đang cung cấp cho họ chỉ những thông tin cần thiết cho công việc và việc tuyển dụng chứ không phải tất cả những gì về bạn.
Tìm việc cũng cần nhiều may mắn, nhưng cần nhiều hơn sự chuẩn bị và quan trọng hơn là một cơ hội để bạn đánh giá chi tiết lại bản thân và hoạch định cho tương lai. Chúc bạn chuẩn bị được một CV tốt và tìm được công việc thích hợp cho bạn đóng góp và phát triển nghề nghiệp.

Wednesday, 28 March 2012

Hiring pentesters - http://blog.pentesterlab.com

Hiring the right people is becoming harder and harder. I decided to share some tips and feedback based on few years of reading resumes and interviewing people.

I don't think you can really have an equation to rate the right person, I think it's more like a list of things I like or dislike in a resume.

In my opinion, the best hiring process follows the following steps (for the technical side of it):
  • Review resume.
  • Technical interview.
  • Hands-on interview.
  • Drinks.
In this first post, I'm going to provide more details on how I review a resume and what affect my decision.

Pre-processing:
  • Resume looks ugly: -1
  • Obvious spelling mistakes in the resume: -3 (native speakers), -1 (others)
  • Resume sent by a recruiter: +/- 5, some recruiters can take a resume and make it looks terrible or can make it look better...
  • Buzzwords in the resume: -3
  • Hotmail address: -3 ("Excuse me, are you from the past?")
  • Own domain name: +2, with own SMTP server: +3
  • Number of occurrence of the word "hack" in the resume: -1 per occurrence
  • No internet presence: +/-10, can indicate the best and the worst

Formation:
  • Developer formation: +2 someone who can write code will often be more useful than someone who can't
  • Learn different things at school: +3, with special points for Maths, Cryptography, Data Mining, Signal processing, Electronic, ...
  • Didn't go to high school: +/-0, some really really smart people didn't spend much time at school.

Job experiences:
  • Job hopper: -5, training people takes time (especially if you're not using our exercises), you cannot afford to hire someone who is going to leave after a year (with your company's knowledge).
  • More than 7 years working for one big company/big 4 and bragging about it: -2, if someone is not happy, he should move on, and not stay at the same place for that long
  • Worked as a developer: +2, someone who can write code will often be more useful than someone that can't.
  • Web site developer: +3, a big part of our job is web-based, knowing how to develop for the web gives people a lot of knowledge needed for penetration testing (common mistakes, ability to review code, ...).

Certifications:
  • CEH: -2, too often I have been disappointed during technical interview by CEH. Most of them just want to hack stuff and don't learn properly how things work.
  • CISSP: -3, CISSP is in my opinion a good certification for people who want to show general knowledge in security... not really the kind of people a pentest company is after in my opinion.
  • ISO-2700*: -4, same as CISSP with even less technical knowledge
  • PCI-DSS: -2, not really technical but some really good people are certified.
  • All of these certifications together: -3
  • Special points for "Firstname Lastname CISSP": -4

IT knowledge:
  • List tool instead of Technic: -3, sqlmap" instead of "sql injection"
  • List really old security tools: -3
  • Obvious lack of security knowledge: -10, Non-sense in the resume for example
Code:
  • github profile: +5
  • github profile with projects: +5, +3 if really good code, +4 if code in different languages
  • github profile with patches for opensource projects: +5 (-3 if advisory published for silly vulnerabilities)

Vulnerabilities:
  • published a vulnerability in some project in version 0.1: -3, +3 if it's a full code review and they found "all" the bugs and report them prior to the disclosure.
  • published a stack-overflow in some Russian mp3 player: -3 (typical CEH profile)

Others:
  • References from someone: +10
  • Twitter account: +1, -1 if only chitchat, -3 if security circus, +2 if real information on vulnerabilities
  • Blog with interesting articles: +5
  • Play CTF: +5
  • Available on IRC: +2
  • Talk during conferences: +5, unless talk on SCADA: -3
  • Read Phrack: +5
  • Wrote in Phrack: +20 (Phrack is the *BIG* deal, writing in phrack shows both a lot of skills and the good attitude)
Hobbies:
  • Any achievement: +3, black belt in some martial arts, won something, ...
  • Did/do some team sports: +/- 0. to be honest I don't think most good pentesters are team players, they are more like traders, sharing information/tools with people they know/like/respect or people who share with them.


I know a lot of people won't agree with this rating, mostly because it's really subjective (and part of it is a bit trollish I guess). However, most of the time it provides a good overview of a resume... Obviously, if I get a resume that matches all these points, I will be really suspicious now :p 
 
==============================================================
 
After the first post on hiring pentesters I thought I had to keep going... A lot of people read it and apparently liked it... If you are really interested by the interview process, matasano's one is pretty impressive...

Before the interview (or even before you read the resume), it's good to have a basic opinion on someone's skills... I wrote a simple website with 20 questions to get a quick feeling of who I'm talking to.

The questions are simple but allow to detect people with no security knowledge. Below are 2 of the 20 questions so you can see what I'm talking about:
  • unmd5 is the PHP function used to retrieve the clear text of a md5 ? True/False
  • Windows passwords are stored in C:\Windows\System32\drivers\etc\shadow ? True/False
If someone passes this test, the real technical interview can start.

As always, you will have the normal security questions (I guarantee most security companies ask for these):
  • explain a tcp handshake
  • how Windows passwords are stored?
  • what is a cookie?
  • opinion on disclosure?
From my experience, I think it's better to ask people to explain things than just to ask them what it's. You can really see what level of understanding people have of a problem...

For example, with Cross Site Scripting, you can have the following responses:
  • "it's a problem of filtering and it allows an attacker to inject script in the page"
  • "it's a problem of filtering and an attacker can display/run arbitrary code in victims' browser"
  • "it's a problem of output encoding and can be used to inject Javascript or HTML in the page sent back to victims"
  • ...
That way, you're able to see if the person really understands what's going on and how he will be able to explain it to someone else.

You need to have 2 types of questions:
  • questions based on memory: "what port is used by X", "what nmap options do you used"
  • questions based on reflection: "how will you solve that problem"

I also have my favorite set of questions:
  • "You're going to PentesterLab's website, explain what happens...", that way you can see someone's knowledge of TCP/IP, DNS, HTTP, SSL, ...
  • "What is the last cool thing you learned/read", that way you can see what people are interested by and where they at
After this test, another interview is setup with hands-on test (only if the person did good enough obviously), it's currently the web application of the exercise "From SQL injection to shell" and it's used to see how people think and behave with a computer.

You can see a lot of different things:
  • what people use for desktop
  • how fast someone is with his computer
  • how people solve a problem
  • if people bring a working laptop (yes it happened, someone came to an interview with a broken gentoo...)
  • learn from people: sometime people show you cool tricks you didn't think of
  • ...
Obviously, not everyone (actually only one person did it without any help so far) knows how to exploit a SQL injection manually (why do you think I created PentesterLab). But during the test, we help people and show how things work to see how they can learn new things and incorporate information into their way of thinking.
 

Wednesday, 29 February 2012

Tutorial on Basics of NIC, MAC and ARP - Author: Abhinav_Singh

Contents


Introduction

In this beginners guide, I am going to explain the basic & important terms of computer networks such as NIC, IP Address, MAC & ARP. This will greatly help you set up your network basics right before you look for advanced stuff.
 
 
Often we straight away jump into using tools and learn quickly from the various technical papers but we tend to forget the basics. This often causes us to lose the ground and eventually lose interest in the same. From that perspective, this tutorial will help you get your ground stable on network basics and get going !


Know the Terms - IP Address, NIC, MAC

You must be familiar with the term IP address. Just like your home has a mailing address in the same way any computer or device connected to the internet have a mailing address called the IP address. It can either be static or dynamic. In case its static then it will remain unchanged every time you connect to a network and if its dynamic then a local DHCP server grants you a new IP address every time you connect to internet.

So with machines coming and going on networks, and IP addresses ever changing, how do other computers on your network find Redbeard? The secret (well, not really a secret; just a fact that veteran administrators know so well, they forgot to tell you) is this: every networked device actually has two addresses. One is the IP address, which might or might not change. The other is the MAC address, which is fixed to the device (can be changed too, read more here).

When you connect a computer to your Ethernet LAN, do you know what you're plugging the Ethernet cable into? From the outside, it looks like you're plugging it into a metal case, but you're not. Inside the case is a Network Interface Card (NIC). A NIC is a special hardware card within any networked device (computer, printer, router, etc.) that handles all the technical aspects of sending and receiving data packets over a computer network.

Like your mailing address at home, your computer's NIC has a unique address. This address must be unique, otherwise, network traffic cannot find its way to the right computer.

The distinctive address that identifies a NIC is called the Media Access Control (MAC) address. A MAC address is formatted as a six-byte, hexadecimal number, like this
 
00:90:7F:12:DE:7F
 
A MAC address is a unique character string, and since it identifies a specific physical device -- one individual NIC -- the MAC address, by convention, never changes for the life of the NIC. Two NICs never have the same MAC address (unless some manufacturer screws up royally [which has happened]). Because your NIC's MAC address is permanent, it's often referred to as the "real" or physical address of a computer.


Why do we need IP when we have MAC?
 
Actually MAC address are fixed hence they are not as scalable compared to IP address. IP address have several other features like subnetting and supernetting which gives a logical understanding of the presence of a machine in a network. These facilities are not with the MAC address.

Also MAC address are not routable. The Internet Protocols will not treat them as an address of a source or destination. Hence IP address in many ways simplifies our task.

The malleable IP address gives your network some flexible manageability. The never-changing MAC provides a specific, reliable address for a physical device.

Or you could say, we have the long and the short of it. IP addresses route a packet across the whole global Internet, while MAC addresses help the packet make the small, local hop between hardware devices. Sophisticated networking is possible because each of your networked devices has both a MAC and an IP address.

With that comes the next question, How MAC and IP co-ordinate?


Lets bring up ARP
 
The simple definition that we study in local networking books about ARP is - network layer protocol that is used to convert IP address into MAC address. Lets get into more details,

We began by wondering, "How do devices on a local network become aware of one another?" NICs and MACs are important pieces of the answer, but your network must learn to pair a MAC address with the IP address for the same machine. It does so using a technique called Address Resolution Protocol (in short ARP).

Think of ARP as network roll call. Remember the first day of your college/school? At the beginning of class, the teacher called from a list of names, expecting you to reply when she called yours. She did this to associate your name with your face. Every student heard every name, but answered only to his or her own name. ARP uses a similar technique to associate an IP address to the MAC address.

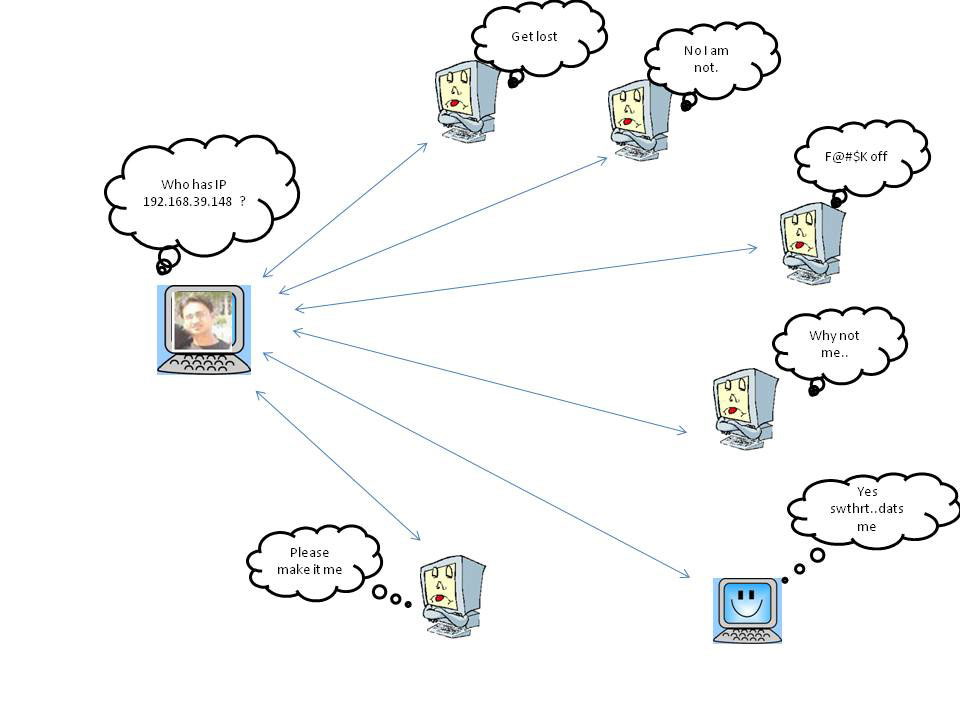
Let's assign Abhinav the IP address, 192.168.39.101, and suppose his NIC has the MAC address, 00:A0:24:30:2E:13. And suppose he need to send a file to Jaya or more literally, to her computer. When Abhinav attempts to send jaya a file, Abhinav first obtains Jaya's IP address. Upon seeing that the IP address is local (on the same subnetwork), Abhinav knows he is capable of sending the file to her destination, if he learns the "real" (MAC) address associated with that IP address. To learn the MAC address, Abhinav does what your teacher did on the first day of school/college. He calls out to the entire local network asking that the computer with the IP in question reply "Here!" with a MAC address.

Let's say that Jaya has the IP, 192.168.39.148. To find the MAC address for Jaya, Abhinav would send the following (simplified) ARP request:
 
From:
(Abhinav's MAC address)
To:
(Broadcast address)
Packet Content
00:A0:24:30:2E:13 FF:FF:FF:FF:FF:FF Who has 192.168.39.148?
Tell 192.168.39.101.
 
Notice the special address in the "To" field above. That special address (all Fs) is the MAC broadcast address. Anything sent to that address goes to every computer on LAN segment. All those computers receive the message, but ignore it, because it doesn't pertain to them -- with the exception of Jaya. Because Jaya is 192.168.39.148, she replies with her MAC address, like this:
 
From:
(Jaya's MAC address)
To:
(Abhinav's MAC address)
Packet Content
00:A0:24:30:4C:23 00:A0:24:30:2E:13 I have 192.168.39.148
 
This is how Abhinav will finally succeed in finally sending his file (not a love letter) to Jaya after identifying her MAC or physical address. In short Abhinav ARPed Jaya.

Here is a picture to demonstrate this process.
 
network basics 
 
Having successfully ARPed, Abhinav stashes the newly-learned MAC/IP pair in an ARP cache. The ARP cache is a small segment of memory your computer reserves to temporarily store a table of MAC addresses and their associated IP addresses. Your computer keeps this table for efficiency so that it doesn't have to keep broadcasting ARP requests to computers it has already queried. If Abhinav need to send something else to Jaya soon (maybe a love letter this time), Abhinav will obtain Jaya's MAC address from his own ARP cache rather than querying it again.


Conclusion

Hope this tutorial will help you to clear most of your doubts on networks basics. When you have sound basics, you can easily solve bigger problems.
Contents


Introduction

In the previous article "Tutorial on Basics of NIC, MAC and ARP" [Reference 1], I wrote about some of the basic network terms NIC, IP Address, MAC & ARP etc.
 
 
Here I will explain in depth about ARP Spoofing, how it can be used to perform local sniffing and possible solutions to protect against such attacks.


ARP Spoofing/Flooding/Poisoning

ARP Spoofing is one of the predominent attacks executed in local network. This attack involves sending fake or spoofed ARP messages onto a LAN.

It is possible to update a host's ARP cache with false information via spoofed ARP Replies. This technique is known as 'ARP Poisoning' and is the basis of more complex attacks. The most dangerous amongst them is Sniffing . Poisoning can also help in causing DoS type of attack too but here we will primilarly focus on Sniffing the network data.

Sniffing is the term used to describe the reading of all packets on a network segment. This is relatively easy on a network connected via a hub as ethernet is a broadcast medium and the attacker would only have to place his NIC in promiscuous mode to 'sniff' all traffic on that network segment. In a switched network this is not possible. This is because a switch builds a table of MAC addresses and their associated ports when the switch is powered on. When a host transmits an ethernet frame the switch examines the destination MAC address and routes the frame to the associated port as given in the switch table. Therefore it is not possible to sniff any traffic on the network.

There are two methods to sniff traffic in a switched environment using ARP Poisoning. The first is for the attacker to send flood of spoofed ARP Replies to the switch. The switch will process these replies, updating its routing table. If this is done at a rapid rate the switches table will overflow and the switch will default to broadcast all traffic to all ports like Hub. The attacker can now 'sniff' all network traffic.
 
 
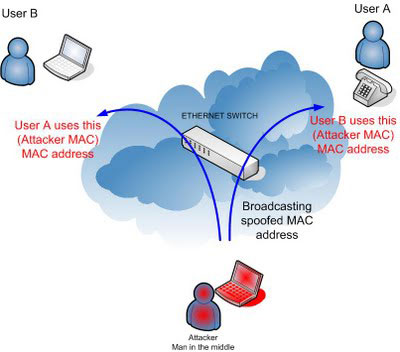
The second method involves a 'man in the middle' (MITM) style attack. I will explain this technique in detail by aid of an example. Below is a simple network segment with three hosts in a switched environment.

The attacker wishes to sniff all traffic that A sends to B and visa versa. This is currently not possible as the attacker is connected to the network via a switch. The correct IP addresses and MAC addresses for each host are as follows:
 
Host IP Address MAC Address
Host A 192.168.0.2 00:00:00:00:00:02
Host B 192.168.0.3 00:00:00:00:00:03
Attacker 192.168.0.4 00:00:00:00:00:04
 
Firstly the Attacker will poison A's ARP cache with a spoofed ARP Reply. The ARP reply will tell A that the IP address of B now has a MAC address of 00:00:00:00:00:04. Once A has processed the ARP Reply its ARP cache will look like this:
 
Host IP Address MAC Address
Host A 192.168.0.2 00:00:00:00:00:02
Host B 192.168.0.3 00:00:00:00:00:04
Attacker 192.168.0.4 00:00:00:00:00:04
 
Secondly the Attacker will poison B's ARP cache with a spoofed ARP Reply. The ARP reply will tell B that the IP address of A now has a MAC address of 00:00:00:00:00:04. Once B has processed the ARP Reply its ARP cache will look like this:
 
Host IP Address MAC Address
Host A 192.168.0.2 00:00:00:00:00:04
Host B 192.168.0.3 00:00:00:00:00:03
Attacker 192.168.0.4 00:00:00:00:00:04
 
Now whenever A sends B an ethernet frame the switch will route it to the attackers port, this will also be the case whenever B sends A an ethernet frame. The attacker may now 'sniff' the traffic whilst forwarding it on to its originally desired host.

The thing to keep in mind here is that the attacker must perform the two way poisoning so that it can recieve the packets as well as send it to the destination. In this way the connection will always be alive between the two communicating hosts and the attack will perform successfully.


Detection & Mitigation
 
One of the solution to prevent ARP cache from being poisoned there by protect against ARP Spoofing, is to add static IP-MAC entries to the cache. If an ARP cache has been made static it will not process any ARP Replies received unlike a dynamic ARP cache.

However this is not practical for large networks as the correct IP address to MAC address association of every host would have to be present in the cache of every host before it is made static. If one host changed its MAC address (e.g. after replacing a NIC) all hosts ARP caches would need to be updated manually. On windows, a login script could automate this process however it has been reported Windows will still accept and process ARP Replies even when the ARP cache has been made static.


Other solution, is to use Intrusion Detection Systems (IDS) to detect ARP Poisoning attacks. You can also use tool, ArpWatch [Reference 2] to monitor against such ARP spoofing attacks on the local network.


ARP Spoofing Demonstration
 
Here is very good flash demonstration (obtained from oxid) which will help you to understand entire 'ARP Spoofing' operation.
 
http://www.securityxploded.com/arp-spoofing.swf 
 
References

 
Conclusion

Hope this tutorial has helped to clear out the basics of ARP Spoofing, its attack vector and possible way to detect/mitigate such attacks.

PDF Overview - Peering into the Internals of PDF

Contents

Introduction

Portable Document Format (PDF) is a file format for representing documents in a manner independent of the application software, hardware, and operating system used to create them and of the output device on which they are to be displayed or printed.
In this introductory article I will explain the internals of PDF document, its structures and components with examples and screenshots.  It will help you understand intrinsics of PDF document and will be more useful if you are into PDF malware analysis.
Components of PDF File

PDF syntax consists of four main components:
  1. Objects
  2. File Structure
  3. Document Structure
  4. Content Stream


PDF Objects
A PDF file consists primarily of objects, of which there are eight types:
  1. Boolean values, representing true or false
  2. Numbers include integer and real
  3. Strings
  4. Names
  5. Arrays, ordered collections of objects
  6. Dictionaries, collections of objects indexed by Names
  7. Streams, usually containing large amounts of data
  8. The null object denoted by keyword null
I will explain more details about each of these objects in detail in the following section.

PDF Objects -> Strings
String objects can be represented in two ways:
  • Literal Strings
  • Hexadecimal Strings
Literal Strings consists of any number of characters between opening and closing parenthesis.
Example
(This is a string objects)
If string is too long then it can be represented using backslash as shown below
(This is a very long\
String.)
Hexadecimal Strings consists of hexadecimal character enclose with angel bracket
Example:
<A0C1D2E3F1>
Here each pair of hexadecimal defines one byte of string.
PDF Objects -> Names
A names object is uniquely defined by sequence of characters. Slash character(/) defined a name.
Example
/secsavvy
/SecSavvy
Both are different name.
/Sec#20Savvy mean Sec Savvy 20 is hexadecimal value for white space.
Note: Pdf is case-sensitive.
PDF Objects -> Array
An array object is collection of objects. PDF array object can be heterogeneous. It is defined with square brackets.
Example
[1 (string) /Name 3.14]
PDF Objects -> Dictionary
Dictionary object consists of pairs of objects. The first element is key and the second is value.

The key must be name. A dictionary is written as a sequence of key-value pairs enclosed in double angle brackets (<< � >>).
Example
<< /Type /Pages
/Kids [ 4 0 R ]
/Count 1
>>
Count is a key and 1 is value.
PDF Objects -> Streams
A stream object, like a string object, is a sequence of bytes. Stream can be of unlimited length, whereas a string is subject to an implementation limit. For this reason, objects with potentially large amounts of data, such as images and page descriptions, are represented as streams.

A stream consists of a dictionary followed by zero or more bytes bracketed between the keywords stream and endstream:
dictionary

stream
... Zero or more bytes ...
endstream
PDF Objects -> Indirect Ones
Objects may be labeled so that they can be referred to by other objects. A labeled object is called an indirect object.
Example
Consider this object
obj and endobj is a keyword.

10 0 obj
(SecSavvy String)
endobj

This object defined a string of object number 10.
This object can be referred in a file by indirect reference as
10 0 R
PDF Objects -> Streams -> Filters
A filter is an optional part of the specification of a stream, indicating how the data in the stream must be decoded before it is used. For example, if a stream has an ASCIIHexDecode filter, an application reading the data in that stream will transform the ASCII hexadecimal-encoded data in the stream into binary data.

For data encoded using LZW and ASCII base-85 encoding (in that order) can be decoded using the following entry in the stream dictionary:

/Filter [ /ASCII85Decode /LZWDecode ]
Example1 0 obj
<< /Length 534 /Filter [ /ASCII85Decode /LZWDecode ]>>

stream

J..)6T`?p&<!J9%_[umg"B7/Z7KNXbN'S+,*Q/&"OLT'FLIDK#!n`$"<Atdi`\Vn%b%)&'cA*VnK\CJY(sF>c!Jnl@RM]WM;jjH6Gnc75idkL5]+cPZKEBPWdR>FF(kj1_R%W_d&/jS!;iuad7h?[L-F$+]]0A3Ck*$I0KZ?;<)CJtqi65XbVc3\n5ua:Q/=0$W<#N3U;H,MQKqfg1?:lUpR;6oN[C2E4ZNr8Udn.'p+?#X+1>0Kuk$bCDF/(3fL5]Oq)^kJZ!C2H1'TO]Rl?Q:&�<5&iP!$Rq;BXRecDN[IJB`,)o8XJOSJ9sDS]hQ;Rj@!ND)bD_q&C\g:inYC%)&u#:u,M6Bm%IY!Kb1+�:aAa�S`ViJglLb8<W9k6Yl\\0McJQkDeLWdPN?9A�jX*al>iG1p&i;eVoK&juJHs9%;Xomop�5KatWRT�JQ#qYuL,JD?M$0QP)lKn06l1apKDC@\qJ4B!!(5m+j.7F790m(Vj88l8Q:_CZ(Gm1%X\N1&u!FKHMB~>

endstream
endobj
Here is the list of standard filters
  • ASCIIHexDecode
  • ASCII85Decode
  • LZWDecode
  • FlateDecode
  • RunLengthDecode
  • CCITTFaxDecode
  • JBIG2Decode
  • DCTDecode
  • JPXDecode
  • Crypt
File Structure
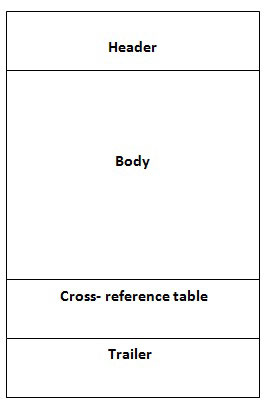
PDF file consists of 4 main elements:
  • PDF header identifying the PDF specification.
  • A body containing the objects that make up the document contained in the file
  • A cross-reference table containing information about the indirect objects in the file
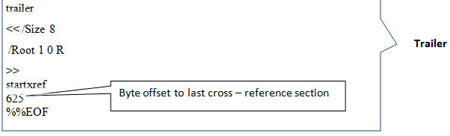
  • A trailer giving the location of the cross-reference table and of certain special objects within the body of the file.
pdf internals
Cross Reference Table
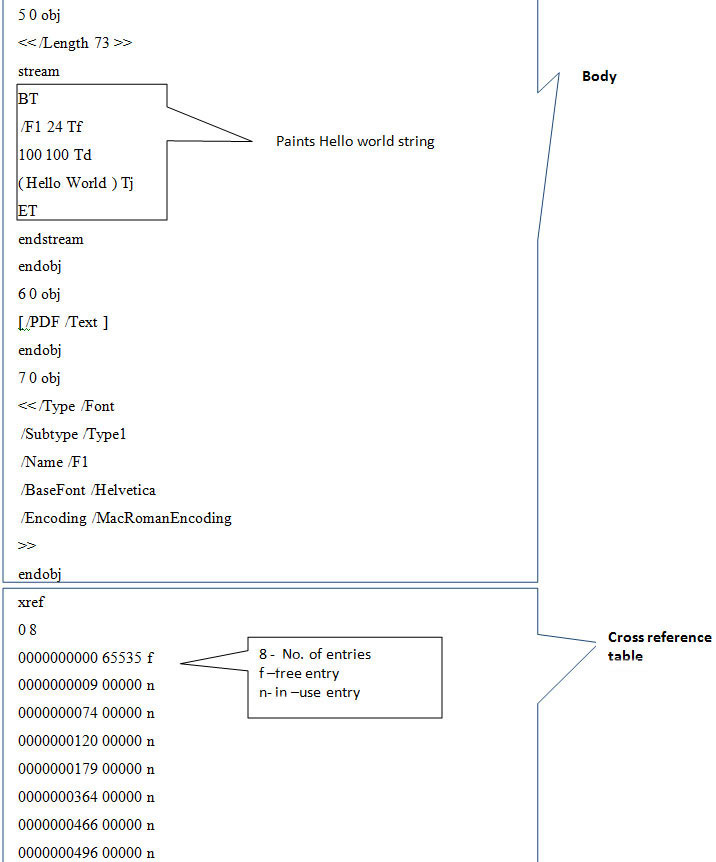
The cross-reference table contains information that permits random access to indirect objects within the file so that the entire file need not be read to locate any particular object. The table contains a one-line entry for each indirect object, specifying the location of that object within the body of the file.

Each cross-reference section begins with a line containing the keyword xref. Following this line are one or more cross-reference subsections, which may appear in any order.

Each cross-reference subsection contains entries for a contiguous range of object numbers. The subsection begins with a line containing two numbers separated by a space: the object number of the first object in this subsection and the number of entries in the subsection. For example, the line

0 8

introduces a subsection containing five objects numbered consecutively from 0 to 8.
xref
0 8
0000000000 65535 f
0000000009 00000 n
0000000074 00000 n
0000000120 00000 n
0000000179 00000 n
0000000364 00000 n
0000000466 00000 n
0000000496 00000 n
0000000009 is 10 digit byte offset in the case of in-use entry , giving the number of bytes from the beginning of the file to the beginning of the object.
0000000000 is the 10-digit object number of the next free object int the case of free entry
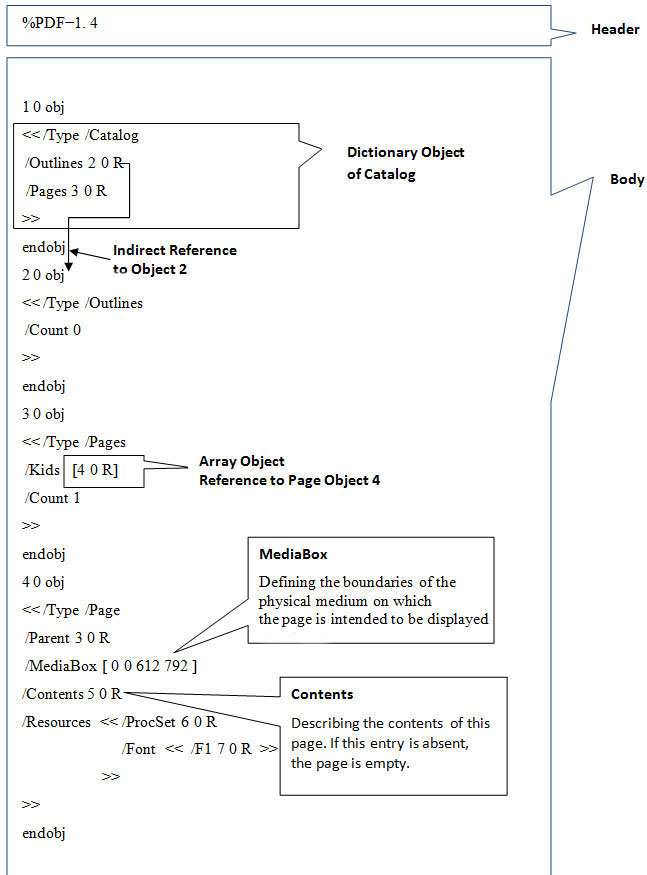
Example Screenshots: Simple Hello World Text PDF
Here are the series of screenshots which shows different parts of sample PDF document. 
Reference
Conclusion
This article explains in brief internals of PDF document, its structures, components with examples and detailed screenshots.  Hope this article will help you in the malware research work revolviing around PDF documents. 

Though it is enough for beginners but advanced users are advised read through reference white paper for more granular details.

Changing MAC Address of the Computer

MAC Address of Computer

Any packet sent to remote system on the network contains MAC address and IP address of your computer. Many of us are still under the impression that IP address can be changed, but MAC address is fixed and cannot be changed unless network card is replaced. Though we cannot change the MAC address of the network card, we can certainly change it in the operating system.

Here are the steps to change the MAC address on various operating systems.
 
 
Changing MAC Address on Linux

On Linux platform you can just use 'ifconfig' command to set the new MAC address as shown below.
ifconfig eth1 down
ifconfig eth1 hw ether 11:12:13:14:15:16
ifconfig eth1 up
 
 
Changing MAC Address on Windows

In windows you can use a console tool called 'etherchange' to change the MAC address. When you run this tool, it will show you all available network interfaces and then you can select particular interface to change its MAC address. You can just disable and enable that network adapter for changes to take effect. Once you have finished playing your game, you can run this tool again to restore the MAC address back to original.

It is basically achieved through a following registry hack. Open up your registry editor and move to the following location.
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Control\Class\
{4D36E972-E325-11CE-BFC1-08002bE10318}
 
 
The above key has many subkeys with names such as 0000, 0001, 0002 etc. Each of these keys have a "DriverDesc" value on the right side which contains the description of the network card. You have to go through each one of these entries until you find out the one with the same description as your current network interface. Once you have found it, just create following string value to set new MAC address (in hexadecimal).
 
NetworkAddress REG_SZ 111213141516

Once you have changed it, disable & re-enable the network card for changes to take effect. Then use the command 'ipconfig  /all' to verify new MAC address. To set that network interface back to the original address, just delete the above value from registry.
 
Now you know what can be changed and what not..!
 
 
References

Mật mã khóa công khai: hành trình 35 năm - Phan Dương Hiệu (blog KHMT)

Mã hóa khóa công khai ra đời cách đây 35 năm, đánh dấu bởi công trình khoa học của Whitfield Diffie và Martin Hellman. Đó thực sự là một bước ngoặt đưa mật mã từ một nghệ thuật thành một ngành khoa học. Trong quá trình 35 năm phát triển, những phát kiến trong mật mã hầu hết rất phản trực quan, và do đó càng bất ngờ thú vị, đã có ảnh hưởng lớn đến nhiều ngành khoa học khác: áp dụng những kết quả trừu tượng trong lý thuyết số vào thực tế; thúc đẩy sự phát triển của các thuật toán xác suất; đưa ra những khái niệm quan trọng trong lý thuyết tính toán mà điển hình là khái niệm chứng minh tương tác; tạo cầu nối giữa lý thuyết số và khoa học máy tính thông qua lý thuyết số tính toán… Trong bài này, chúng tôi sẽ điểm sơ qua sự phát triển của mật mã trong mối liên hệ với các ngành khoa học khác, và thảo luận về những hướng phát triển của mật mã trong những năm tới.

Thay đổi trong cách tiếp cận tính an toàn.
Từ ngàn xưa con người ta đã có nhu cầu trao đổi bí mật: từ những mệnh lệnh trong các cuộc chiến tranh cho đến những hẹn hò thường nhật. Ta tìm thấy vết tích của mật mã từ thời Ai cập cổ đại, cho tới hệ mã nổi tiếng mà Ceasar dùng trong thời La mã, cho tới bức thư tình mà George Sand gửi cho Alfred de Musset… Ở thời kỳ sơ khai, mật mã có thể coi như nghệ thuật che giấu thông tin mà độ an toàn đạt được là nhờ có sự thống nhất một qui ước bí mật chung. Như vậy, thuật toán lập mã và giải mã là bí mật. Nhưng khi tầm ứng dụng càng rộng thì yêu cầu bí mật cơ chế mã lại càng không hợp lý vì nhiều người sử dụng nên tất yếu sẽ rất dễ bị lộ. Cuối thế kỷ 19, Kerckhoffs đề nghị một nguyên tắc xem xét độ an toàn chỉ dựa trên khóa bí mật còn thuật toán lập mã/giải mã không cần phải giữ kín. Qui tắc này đến nay vẫn còn là rất cơ bản. Xuyên suốt thế kỷ vừa qua, người ta đã xây dựng được rất nhiều các cơ chế mã tốt, với độ an toàn dựa trên sự bảo mật của khóa chung giữa người gửi và người nhận. Tuy vậy, sự cần thiết chia sẻ khóa bí mật là một điểm bất thuận lợi, nó là rào cản lớn cho việc trao đổi thông tin trên diện rộng: ví dụ để thiết lập kênh bí mật đôi mội giữa một nghìn người thì cần tới cả nửa triệu khóa bí mật.
Mật mã khóa công khai đã vượt qua rào cản đó và đưa đến một bước ngoặt trong sự phát triển ngành mật mã. Ý tưởng chính của nó khá giản đơn: lập mã và giải mã là hai quá trình có bản chất khác nhau, nếu như giải mã nhất thiết phải dùng khóa bí mật (nếu không ai cũng giải được) thì lập mã lại không nhất thiết như vậy, và thậm chí sẽ càng tốt hơn khi ai cũng có thể lập mã. Do vậy, nếu ta có thể sinh ra một khóa bí mật cho giải mã và một khóa công khai tương ứng cho lập mã thì quá trình lập mã không còn cần bất kỳ bí mật nào. Tuy có vẻ tự nhiên nhưng việc mã hóa sử dụng khóa công khai làm thay đổi hoàn toàn yêu cầu về sự an toàn: khóa bí mật không cần chia sẻ nữa, mỗi người có khóa bí mật của riêng mình và chỉ cần giữ kín nó, không cần thiết phải chia sẻ nó với bất kỳ ai khác. Sự đảm bảo an toàn không còn cần dựa trên sự tin tưởng lẫn nhau giữa người gửi và người nhận.
Mật mã khóa công khai còn làm thay đổi hoàn toàn phạm vi ứng dụng, cho phép mật mã được sử dụng rộng rãi trong thực tế: việc thiết lập kênh bí mật giữa một nghìn hay một triệu người thì cũng chỉ yêu cầu mỗi người cần giữ một khóa bí mật và công bố một khóa công khai, không cần phải thống nhất khóa chung nào. Áp dụng vào thực tế, một cửa hàng trực tuyến có thể thu hút hàng triệu khách hàng mà chỉ cần công khai duy nhất một khóa để ai mua hàng cũng chỉ cần dùng khóa công khai đó để gửi thông tin bảo mật về thẻ thanh toán.

Mật mã với lý thuyết độ phức tạp tính toán
Bên cạnh những ưu điểm mang tính bước ngoặt, mã hóa khóa công khai ẩn chứa một điều đáng lo ngại về tính an toàn: khi công bố khóa công khai tương ứng với khóa bí mật sẽ có thể dẫn tới việc khóa bí mật không còn … hoàn toàn bí mật! Điều lo ngại đó hoàn toàn có cơ sở bởi một kẻ tấn công có thể thử hết các trường hợp có thể để tìm ra khóa bí mật tương ứng với khóa công khai. Do đó, về nguyên tắc, kẻ tấn công có thể phá được sơ đồ mã hóa, tìm ra khóa bí mật mà không cần quan sát bất kể bản mã nào! Chính vì thế mà độ an toàn của mật mã khóa công khai sẽ không thể chỉ dựa trên sự giữ bí mật khóa nữa. Muốn đảm bảo sự an toàn, ta phải chứng tỏ làm sao, dù về nguyên tắc, kẻ tấn công có thể tìm ra khóa bí mật, nhưng thời gian để đạt được mục đích đó phải là rất lớn, cỡ hàng triệu năm trên một máy tính nhanh nhất chẳng hạn. Hay nói cách khác, độ phức tạp mà kẻ tấn công có thể tìm lại khóa bí mật là lớn phi thực tế.
Một cách rất tự nhiên, nghiên cứu độ an toàn của mật mã khóa công khai đã nằm gọn trong lý thuyết độ phức tạp tính toán (Computational Complexity). Trong lý thuyết độ phức tạp, ta không chỉ quan tâm xem một bài toán có thể giải được hay không, mà điều quan trọng nhất là nghiên cứu xem để giải bài toán đó thì độ khó khăn lớn đến đâu. Độ phức tạp được phân cấp theo các lớp, trong đó hai lớp quan trọng nhất là lớp P và lớp NP. Lớp P bao gồm những bài toán giải được trong thời gian đa thức, và nó được coi là lớp các bài toán có thể giải được trong thực tế. Chẳng hạn các bài toán sắp xếp dữ liệu theo một thứ tự định sẵn, tìm đường đi ngắn nhất giữa hai thành phố, biến đổi Fourrier rời rạc (đều có thể thực hiện được với cỡ nlog(n) bước cho n đối tượng, tức là bị chặn bên bởi một đa thức p(n)=n^2) là những bài toán trong P. Lớp NP là lớp các bài toán có thể kiểm tra được lời giải đúng hay sai trong thời gian đa thức. Chẳng hạn trò chơi Sudoku thuộc lớp NP vì để giải nó có thể rất khó (thậm chí nó được chứng minh là một trong những bài toán thuộc lớp khó giải nhất trong NP) nhưng để kiểm tra một phương án có là lời giải không thì có lẽ chỉ cần đến một cậu bé biết phân biệt các con số với nhau và duyệt qua tất cả các ô. Rõ ràng chỉ khi lời giải có thể kiểm tra được trong thực tế thì bài toán mới được quan tâm, do vậy mà lớp NP có vai trò quan trọng. Câu hỏi trọng tâm của lý thuyết độ phức tạp là liệu các bài toán trong NP có thể có lời giải thực tế (tức trong thời gian đa thức) hay không, tức liệu P có bằng NP? Nếu P=NP thì điều đó đem lại một sự bất ngờ cho nhận thức của chúng ta: việc tìm ra lời giải cũng chỉ khó như việc kiểm tra lời giải. Điều khó tin đó làm người ta thường giả thuyết rằng P khác NP. Sự quan trọng của câu hỏi “P chọi NP?” là lý do để nó được viện Clay xếp vào một trong bảy bài toán thiên niên kỷ.
Quay trở lại với lý thuyết mật mã và xem xét nó dưới góc nhìn của lý thuyết độ phức tạp. Giờ đây ta có thể định nghĩa hệ mã bị phá nếu như có thuật toán phá mã (tìm lại khóa bí mật từ khóa công khai, hay đơn giản hơn, tìm lại bản rõ từ bản mã) trong thời gian đa thức. Vậy độ phức tạp của thuật toán phá mã liệu có thể đánh giá trong trường hợp chung? Câu trả lời là có và với mọi sơ đồ mã hóa khóa công khai đều có thuật toán phá mã thuộc lớp NP: do điều kiện cần của hệ mã là khi giải mã ta phải tìm lại đúng bản rõ, bài toán kiểm tra xem 1 khóa bí mật có tương ứng với 1 khóa công khai hay không là dễ dàng (chỉ cần chọn 1 bản rõ, mã nó dùng khóa công khai rồi giải mã nó với khóa bí mật xem có thu lại được đúng bản rõ hay không). Bài toán “P chọi NP” trở nên có tầm quan trọng sống còn tới lý thuyết mật mã: nếu hai lớp này tương đương thì toàn bộ lý thuyết nghiên cứu mật mã dưới góc nhìn độ phức tạp sẽ hoàn toàn sụp đổ vì việc phá mã, vốn thuộc NP, khi đó sẽ có thể thực hiện được trong thời gian đa thức. Và cũng do vậy, nghiên cứu độ phức tạp trong mật mã cần phải dựa trên giả thuyết “P khác NP”.
Hàm cửa lật một chiều và sự phát triển của lý thuyết số tính toán
Khi tính an toàn chia tay với nghệ thuật che giấu bí mật để chuyển sang dựa trên lý thuyết độ phức tạp thì cũng là lúc mật mã bất ngờ tìm đến và làm những nghiên cứu trừu tượng trong lý thuyết số bỗng có những áp dụng đầy ý nghĩa trong thực tế. Nó cũng đưa lý thuyết số tính toán (computational number theory) trở thành một nhánh nghiên cứu quan trọng, nằm giữa vùng giao thoa của toán học và tin học.
Tựu chung yêu cầu để xây dựng mật mã khóa công khai là: hàm lập mã thì dễ (với khóa công khai), nhưng hàm giải mã thì khó khi không có khóa bí mật. Đó là các hàm cửa lật một chiều (trapdoor oneway functions): tính xuôi thì dễ, tính ngược lại phải khó, nhưng với cửa lật là khóa bí mật thì tính ngược, tức giải mã, cũng phải dễ. Yêu cầu trông có vẻ đơn giản đó nhưng thực tế là sau rất nhiều năm tìm kiếm vẫn chỉ có rất ít hàm có thể thỏa mãn. Các bài toán trong lớp NP-đầy đủ (là lớp các bài khó nhất trong NP, trò chơi Sudoku là một trong số đó; ta chỉ cần giải được 1 bài trong lớp NP-đầy đủ trong thời gian đa thức là đủ để chứng tỏ P=NP) rõ ràng là những ứng cử viên tiềm năng để xây dựng hàm cửa lật một chiều. Nhưng thực tế không hề dễ như ban đầu người ta hình dung, vì hai lý do: thứ nhất là bởi các bài toán NP chỉ quan tâm đến độ khó trong trường hợp xấu nhất, trong khi mã hóa cần mã an toàn cho mọi bản rõ nên cần ít nhất độ khó trong trường hợp trung bình; thứ hai là bởi tính chất cửa lật, bài toán cần khó nhưng với một số thông tin thì nó lại phải trở nên dễ giải, và chính yêu cầu về tính chất cửa lật đó đã khiến nhiều hệ mã dựa trên bài toán NP-đầy đủ (như hệ mã Chor-Rivest dựa trên bài toán xếp ba lô) bị phá vỡ.
Những hàm cửa lật thông dụng trong mật mã đã đến từ những bài toán rất cổ điển của lý thuyết số! Đó là bài toán phân tích số (cho một số N = pq là tích của hai số nguyên tố, phân tích nó ra thừa số nguyên tố p,q) và bài toán logarit rời rạc trong trường hữu hạn (cho một phần tử sinh g của một nhóm con của một trường hữu hạn, và một phần tử nhóm u=ga, bài toán là phải tìm lại a). Cả hai bài toán này, tuy về mặt toán học là giải được, nhưng cho đến nay không thể giải được trong thời gian đa thức. Bài toán phân tích số là nền tảng cho độ an toàn của hệ mã nổi tiếng RSA, và bài toán logarit rời rạc là cơ sở cho hệ mã Elgamal. Chính vì tính phổ dụng của hai hệ mã này mà một cách tất nhiên, bài toán phân tích số và bài toán logarit rời rạc trở thành đối tượng nghiên cứu rất được quan tâm. Việc nghiên cứu tính phức tạp của việc tìm ra lời giải cho các bài toán lý thuyết số đã đưa tới sự phát triển sâu rộng của lý thuyết số tính toán.
Sau nhiều công trình nghiên cứu quan trọng thì các bài toán bài toán phân tích số và bài toán logarit rời rạc tuy chưa giải được trong thời gian đa thức nhưng cũng không cần đến thời gian hàm mũ để giải nó, mà đã có các thuật toán dưới mũ (sub-exponention) như thuật toán dùng tính chỉ số (index calculus) và thuật toán dùng đường cong elliptic của Lenstra, được giới thiệu năm 1985. Dù cho những công trình này không làm các hệ mã sụp đổ, nhưng nó buộc phép xây dựng các hệ mã phải giảm hiệu quả vì phải dùng các khóa dài hơn để đảm bảo an toàn. Công trình của Lenstra cũng đánh dấu lần đầu tiên lý thuyết các đường cong elliptic được sử dụng vào mật mã, ở đây có vai trò như phá mã. Điều thú vị là ngay sau đó thì lý thuyết các đường cong elliptic đã được sử dụng cho việc lập mã. Koblitz và Miller cùng độc lập đề nghị thay thế việc sử dụng nhóm trong trường hữu hạn bằng nhóm các điểm trên đường cong elliptic vì ở đó, các thuật toán dưới mũ đã biết để giải quyết bài toán logarit rời rạc có vẻ như không thể áp dụng được. Từ đó việc sử dụng đường cong elliptic dẫn tới dẫn đến những hệ mã hiệu quả hơn (do không cần phải chọn khóa quá dài để chống lại các thuật toán dưới mũ).
Các kết quả lý thuyết sâu sắc trong lý thuyết số tiếp tục được áp dụng vào mật mã. Việc sử dụng đường cong elliptic dẫn tới yêu cầu cần phải lựa chọn những đường cong phù hợp. Tấn công MOV (đưa ra bởi Menezes, Okamoto, và Vanstone) chỉ ra không phải loại đường cong elliptic nào cũng có thể được sử dụng, bằng cách đưa việc giải quyết bài toán logarit rời rạc trên đường cong elliptic trở lại bài toán logarit rời rạc trên một trường hữu hạn mở rộng với độ mở rộng tùy thuộc vào loại đường cong. Do đó, các đường cong siêu lạ (supersingular) rất được ưa dùng ở giai đoạn đầu lại trở nên rất yếu vì ở đó độ mở rộng chỉ cao nhất là 6. Nét đặc biệt trong tấn công MOV là việc sử dụng phép ghép cặp (pairings) trên các đường cong elliptic, với những kết quả khá mới mẻ trong lý thuyết số. Không chỉ phục vụ cho việc phá mã, việc sử dụng phép ghép cặp sau đó đã trở nên cực kỳ hữu hiệu trong việc xây dựng mã. Khởi đầu là Joux đã dùng phép ghép cặp để xây dựng sơ đồ  trao đổi khóa 3 bên, nhưng sự kiện nổi bật là việc dùng phép ghép cặp để giải quyết vấn đề mở về xây dựng mã hóa dựa trên danh tính-Identity based Encryption. Một cách giản đơn, mã hóa dựa trên danh tính cho phép ta sử dụng một khóa công khai duy nhất cho tất cả mọi người (từ đó giải quyết được vấn đề quản lý khóa của mã hóa khóa công khai, tuy vậy nhược điểm của nó là lại cần có thêm người quản trị đáng tin cậy để sinh ra khóa công khai chung và khóa bí mật cho từng người) và hàm lập mã dựa trên khóa công khai chung và danh tính của người nhận như địa chỉ email.  Sau khi Sakai-Ohgishi-Kasahara và Boneh-Franklin đưa ra lời giải cho bài toán mã hóa dựa trên danh tính vào những năm 2000, phép ghép cặp đã được sử dụng hầu khắp trong mọi lĩnh vực của mật mã (mã hóa, chứa ký điện tử, sơ đồ định danh…) để nâng cao tính an toàn và hiệu quả và đôi khi là giải quyết những bài toán mở đã bế tắc trong thời gian dài (chẳng hạn như trong việc xây dựng chữ ký nhóm). Đến cách đây vài năm người ta đã tổ chức hẳn một hội nghị (Pairing-based Cryptograhy) dành cho các nghiên cứu liên quan đến các thuật toán xây dựng và phân tích các phép ghép cặp trên các đường cong elliptic hay hyperelliptic và các phương pháp mã và tấn công mã dựa trên phép ghép cặp.
Nhìn lại các phát triển của lý thuyết số tính toán, ta nhận thấy các phương pháp mới thường được đề nghị đầu tiên cho phá mã, nhưng rồi sau đó lại được sử dụng rất hiệu quả cho việc lập mã. Điều đó cũng phần nào chứng tỏ vai trò tương hỗ giữa cộng đồng những người thám mã và lập mã: trong rất nhiều trường hợp, chính những người say mê tìm cách phá tính an toàn của các hệ thống mật mã, sẽ là những người đem tới những phát kiến mới mẻ để xây dựng những hệ mã an toàn hơn.

Đảm bảo tính an toàn và sự phát triển của lý thuyết các thuật toán xác suất
Để có thể cài đặt được hệ mã RSA, một phần tất yếu là sự cần thiết phải tìm được những số nguyên tố lớn để có thể đảm bảo yêu cầu an toàn tối thiểu (khóa công khai chứa tích của hai số nguyên tố, và nếu một trong hai số nguyên tố là nhỏ thì bài toán phân tích số sẽ là dễ). Từ đó mà yêu cầu tìm các số nguyên tố lớn trở nên rất cần thiết.
Cho tới nay, các phương pháp tìm số nguyên tố lớn đều theo nguyên tắc hai bước: bước 1 là chọn một số tự nhiên đủ lớn và bước 2 là kiểm tra xem số được chọn có là số nguyên tố hay không. Do các số nguyên tố có cấu trúc rất bí hiểm và ta chưa hiểu được quy luật tường minh của chúng nên bước 1 chưa có cách nào khác là chọn một số ngẫu nhiên. Bước thứ 2 là bước kiểm tra tính nguyên tố. Chính những thuật toán kiểm tra tính nguyên tố, mà điển hình là những thuật toán được sử dụng rộng rãi của của Rabin và Solovay, Strassen,  đã khởi đầu cho việc dùng xác suất để thiết kế các thuật toán (chú ý rằng trước đó khá lâu phương pháp xác suất đã được Erd ̋os sử dụng trong việc chỉ ra sự tồn tại của các đối tượng tổ hợp). Các thuật toán xác suất cho ta lời giải không hoàn toàn chính xác, nhưng độ không chính xác có thể làm nhỏ tới bao nhiêu cũng được, với điều kiện đầu vào của thuật toán có một nguồn ngẫu nhiên đủ lớn.
Việc phát triển các thuật toán xác suất dẫn tới sự cần thiết tìm nguồn ngẫu nhiên đủ lớn. Điều đó dẫn tới việc nghiên cứu những bài toán sau đó đã trở nên rất có ý nghĩa trong khoa học máy tính như bài toán trích nguồn ngẫu nhiên (randomness extractor, nhằm từ một nguồn không hoàn toàn ngẫu nhiên ta phải trích ra từ đó một lượng tin có độ ngẫu nhiên cao)  và bài toán sinh dãy giả ngẫu nhiên (pseudo-random generator – từ một nguồn ngẫu nhiên nhỏ làm sao sinh ra một nguồn gần như ngẫu nhiên lớn hơn rất nhiều, nó không hoàn toàn ngẫu nhiên nhưng không có thuật toán nào trong thời gian đa thức có thể chỉ ra tính không ngẫu nhiên của nó)
Sau nhiều phát triển quan trọng của lý thuyết thuật toán xác suất, người ta quay lại hoài nghi “liệu độ ngẫu nhiên có thực sự mang tới sự hiệu quả?”. Bài toán “BPP chọi P” (ở đó BPP là lớp các bài toán giải được theo nghĩa xác suất) là một bài toán mở trọng tâm của lý thuyết độ phức tạp. Cũng như bài toán “P vs. NP”, nếu câu trả lời là hai lớp tương đương thì nó sẽ dẫn tới một khẳng định bất ngờ: mọi thuật toán xác suât đều có thể có thuật toán tất định tương đương. Bên cạnh câu hỏi tổng quan này, các nhà nghiên cứu quay lại với bài toán tìm số nguyên tố nhằm đưa ra một lời giải tất định cho nó. Công trình lý thuyết đột phá của Agrawal–Kayal–Saxena đưa ra năm 2000, đã chỉ ra một thuật toán tất định để kiểm thử tính nguyên tố trong thời gian đa thức, giải quyết trọng vẹn bước thứ 2 một cách tất định. Sự hấp dẫn của một lời giải hoàn chỉnh cho bài toán tất định tìm số nguyên tố chính là nguồn cảm hứng chung rất lớn của các nhà toán-tin học và nó được chọn là bài toán khởi đầu cho một kế hoạch đầy tham vọng nhằm thay đổi tư duy trong hợp tác nghiên cứu khoa học: hợp tác mở thông qua đóng góp, trao đổi mở trên mạng. Với sự nhiệt tình của Timothy Gower, Terence Tao  (cả hai đều đạt giải thưởng Fields), đã có rất nhiều nhà khoa học tham gia vào dự án mở Polymath để cùng trao đổi nhằm tìm kiếm lời giải cho bài toán này. Tuy chưa thể đưa ra lời giải toàn phần, họ đã có một số kết quả dẫn tới một bài báo khoa học dưới tên tác giả Polymath. Rất có thể đây sẽ là một hình thức cộng tác khoa học xuyên biên giới có sức mạnh tổng hợp lớn trong tương lai.
Chứng minh tương tác không để lộ tri thức

Trong mật mã, mọi trao đổi thông tin đều giả thiết có sự hiện diện của kẻ xấu. Mục đích của ta là vừa có thể thuyết phục người đối thoại về tính đúng đắn của một mệnh đề nào đó, lại vừa không cần tin tưởng anh ta, và không muốn sau khi trao đổi anh ta cũng có khả năng chứng minh mệnh đề đó với người khác. Chẳng hạn, một thành viên của một câu lạc bộ bí mật muốn chứng minh danh tính của mình cho người gác cổng, nhưng lại không muốn nói mật khẩu của mình vì sợ chính người gác cổng sẽ bán nó cho kẻ khác. Trong ngữ cảnh đó, một trong những khái niệm thú vị nhất của khoa học máy tính đã được đề nghị: chứng minh tương tác (interactive proofs). Khái niệm này được đưa ra bởi Goldwasser, Micali và Rackof vào đầu những năm 80 và nhờ đó họ đã được trao giải Godel đầu tiên trong lịch sử (giải thưởng hàng năm cho công trình lý thuyết xuất sắc nhất trong khoa học máy tính).
Dưới góc độ toán học, ta thường quan niệm chứng minh là một dãy các lập luận lô gíc có thể trình bày tường minh trên giấy. Liệu chăng yếu tố đối thoại, tương tác giữa người chứng minh và người kiểm tra có mang đến điều mới mẻ? Để trả lời câu hỏi đó, trước hết khái niệm về một chứng minh sẽ phải thay đổi. Goldreich thường trích lời thầy giáo Simon của mình khi giảng về các chứng minh tương tác:
“chứng minh là bất kể cách gì có thể thuyết phục được tôi” (“ A proof is whatever convinces me”).

Theo nghĩa đó, một chứng minh tương tác là một chuỗi các chất vấn, cho tới khi người hỏi bị thuyết phục hoàn toàn bởi người chứng minh. Một câu chuyện vui kể rằng, rằng, một cậu bé cho rằng mình có câu thần chú để mở vách ngăn giữa hai nhánh của một hang động. Tất nhiên cậu ta không muốn lộ câu thần chú của mình, nhưng lại muốn chứng minh khả năng đó.  Trò chơi đuổi bắt có thể là một chứng minh tương tác hiệu quả: chú bé chạy vào 1 trong hai ngã, một người đuổi chon một hướng nhằm dồn chú vào ngách ngăn nhưng cuối cùng không lần nào bắt được chú. Nếu đuổi một lần ta có thể cho là chú đã chọn ngã khác, nhưng lặp đi lặp lại trò chơi tới 100 lần mà không lần nào đuổi được thì có lẽ ta bị thuyết phục là chú đúng là có câu thần chú (ví dụ lấy từ Wikipedia). Các chứng minh tương tác hầu hết dựa trên một tinh thần như thế.

Có những bài toán mà người ta chưa biết cách nào chứng minh trong thời gian đa thức, nhưng lại chứng minh được thông qua tương tác, chẳng hạn bài toán chứng minh hai đồ thị không đồng cấu với nhau.  Hơn thế nữa, trong nhiều bài toán, người chứng minh có thể không cần để lộ ra bất kể tri thức nào anh ta có về cái chứng minh đó (zero-knowledge proofs).

Kết quả rất đẹp của Goldreich, Micali và Wigderson cho ta kết quả bất ngờ: dựa trên giả thuyết tồn tại các hàm một chiều, tất cả những gì ta có thể chứng minh trong thực tế (theo nghĩa trong thời gian đa thức), đều có thể chứng minh mà không để lộ tri thức! Bài toán chứng minh danh tính phía trên là một trong số đó.
Các chứng minh không để lộ tri thức đặc biệt quan trọng trong mật mã, là thành phần cơ bản trong việc xây dựng các sơ đồ mã hóa, chữ ký điện tử. Chứng minh không để lộ tri thức cũng là thành phần không thể thiếu trong một sơ đồ bầu cử điện tử, cho phép mỗi cử tri kiểm tra được lá phiếu của mình đã được tính đến mà việc kiểm phiếu lại không cần phải công bố nội dung từng lá phiếu, đảm bảo quyền lựa chọn bí mật của cử tri.
Ở một khía cạnh khác, chứng minh tương tác cũng là phần hồn của nhánh khoa học «chứng minh tính bảo mật » (provable security), nơi ta cố gắng chứng minh tính an toàn của hệ thống trong một thế giới tương tác rất phức tạp (với sự hiện diện của kẻ tấn công luôn muốn lừa hệ thống thông qua quan sát, nghe trộm, đóng giả người tốt để tương tác với hệ thống) dựa trên những giả thuyết tĩnh, giản đơn của toán học.
Một số hướng đi tương lai của mật mã

Bảo mật trong điện toán đám mây (cloud computing)
Điện toán đám mây cho phép ta lưu trữ những khối lượng thông tin khổng lồ trên mạng và thực hiện các thao tác trên nó một cách dễ dàng. Nó có thể giúp ta giải quyết những bài toán lớn mà trước đây khó có thể giải quyết trên một mạng lưới các máy tính mang tính chất cục bộ. Tuy nhiên, điều đó mang tới một thách thức vô cùng lớn về tính bảo mật. Có hai điều có vẻ như mâu thuẫn nhau: lưu trữ dữ liệu lớn trên các hệ thống xa lạ rõ ràng rất dễ bị đánh cắp thông tin, nhưng nếu ta mã hóa toàn bộ dữ liệu thì sẽ khó có thể tận dụng sức mạnh của tính toán đám mây để thao tác dữ liệu đó.
Nhưng gần đây, vấn đề tưởng khó có thể giải quyết này đã có chút tia hy vọng, với công trình của Gentry năm 2009 về mật mã đẳng cấu theo cả phép nhân và phép cộng (fully homomorphic encryption). Hệ mã này cho phép, từ hai bản mã của hai bản rõ m và m’, ta có thể tính được bản mã nhân của mm’ và bản mã cộng của m+m’. Vấn đề với bề ngoài đơn giản nhưng chứa đựng không ít nghịch lý trong đó: hệ mã vừa phải đảm bảo an toàn cho dữ liệu (không thể biết thông tin về bản rõ m, m’), mà lại vẫn thao tác được trên dữ liệu đó. Và cũng với bề ngoài giản đơn như vậy, nó lại mang đến một ý nghĩa rất bao quát: do mọi tính toán đều có thể qui về các phép toán cơ bản là cộng và nhân, một hệ mã như thế sẽ cho ta khả năng làm mọi tính toán trên dự liệu được mã hóa! Điều đó có nghĩa ta có thể để tất cả dữ liệu bảo mật trên những máy mạng không an toàn mà vẫn có thể tận dụng được sức tính toán lớn của điện toán đám mây để thao tác trên dữ liệu được mã hóa. Tuy nhiên, hiện tại, hệ mã Gentry và một số hệ mã cải tiến còn có hiệu quả vô cùng thấp, hầu như chỉ mang tính lý thuyết. Một hệ mã hiệu quả sẽ là lời giải tuyệt vời cho bài toán an toàn thông tin trong điện toán đám mây.
Mở rộng mô hình mã hóa: cho đối tượng nhóm và cho việc giải mã bộ phận

Mã hóa thường cho ta thiết lập kênh trao đổi thông tin giữa một người với một người. Tuy nhiên, những ứng dụng thực tế đòi hỏi khả năng ta mã một lần sao cho nhiều người cùng có thể giải mã. Một ví dụ điển hình là việc phát chương trình truyền hình mã hóa sao cho hàng triệu thuê bao đều giải được mã. Nhưng một ứng dụng như vậy sẽ đặt ra hai vấn đề: mã một lần cho nhiều người (broadcast encryption) và ngăn chặn một người hay một nhóm người thuê bao cấu kết nhau để làm một bộ giải mã giả (tracing traitor). Hiện tại các thuật toán được sử dụng trong truyền hình thuê bao hầu hết đang còn ở thời nguyên thủy: độ an toàn buộc phải dựa trên tính bí mật của thuật toán. Nhưng cũng bởi vậy nên khi một nhóm phá mã có thể phá được nguyên lý bằng kỹ nghệ đảo ngược (reverse engineering) thì thị trường chợ đen có thể bán tràn lan các bộ giải mã giả mà không có cách gì truy lại được ai là thủ phạm.
Hai năm trở lại đây, một hướng nghiên cứu khá mới là về một kiểu mã tổng quát có thể bao quát hết các khái niệm về mã hóa công khai, mã hóa dựa trên danh tính, hay mã hóa một lần cho nhiều người. Đó là loại mã hàm (functional encryption) ở đó nó cho phép người lập mã định nghĩa một cơ chế giải mã để đối với mỗi người nhận, tùy vào thuộc tính được gán có mà có thể truy cập sâu vào bản rõ tới đâu. Cho tới nay, đối với những cơ chế mã với các cấu trúc tương đối phức tạp, các phương án lập mã còn rất hạn chế về hiệu quả. Những kết quả trong tương lai chắc chắn sẽ mang tới những ứng dụng rất hiệu quả, đặc biệt là cho việc truy cập các cơ sở dữ liệu mã hóa lớn.
An toàn trước các tấn công vật lý

Mật mã thường phân tích tính an toàn dựa trên giả thuyết là khóa bí mật được bảo vệ tốt. Tuy nhiên, những tấn công vật lý đôi khi lại có thể tìm ra những thông tin về khóa (chẳng hạn bằng cách đo năng lượng tiêu thụ của máy giải mã trên các bản mã khác nhau). Do vậy, một trong các mục đích của mật mã là tìm cách hình thức hóa các khái niệm tấn công vật lý và tiếp sau đó là thiết kế các sơ đồ mã hóa mà tính an toàn có thể đảm bảo chỉ duy nhất dựa trên các giả thiết toán học. Hướng nghiên cứu an toàn trong mô hình khóa bị lộ (key leakage resilient cryptography) đang khá được quan tâm trong cộng đồng mật mã.

An toàn trước sự tấn công của máy tính lượng tử
Cuối cùng, chúng ta không thể bỏ qua sự hiện diện tiềm tàng của máy tính lượng tử, dù rằng cho tới nay các máy tính lượng tử mới chỉ phân tích được số 21 ra thừa số nguyên tố. Nhưng về mặt lý thuyết, nó có tiềm năng to lớn không thể không kể tới. Công trình của Shor năm 94 đã chỉ ra rằng bài toán phân tích số có thể giải được trong thời gian đa thức bởi máy tính lượng tử.  Bài toán logarít rời rạc trong trường hữu hạn hay trên đường cong elliptic cũng có thể giải được trong thời gian đa thức bởi máy tính lượng tử. Điều đó có nghĩa là các hệ mã thông dụng hiện nay sẽ bị phá vỡ một khi máy tính lượng tử được thiết kế chạy được trên dữ liệu lớn. Để phòng ngừa trước điều đó (dù khả năng sớm xảy ra được đánh giá là rất nhỏ), nhiều nghiên cứu nhằm xây dựng các hệ mã có thể an toàn trước máy tính lượng tử được đề nghị. Hai hướng chính đang được quan tâm là các hệ mã dựa trên mã sửa sai (error correcting codes) và dựa trên lý thuyết lưới Euclid (lattice based cryptography), nơi sự hiện diện của máy tính lượng tử có vẻ như không đem lại hiệu quả đặc biệt.